Le 31 janvier 2025, Pandu Nayak, le vice-président Search de Google, a décrit à des experts du procès antitrust américain un modèle maison baptisé RankEmbed. Ce même modèle sert de base à FastSearch, l’outil qui fournit des pages web à Gemini et à Vertex AI pour ancrer leurs réponses.
Ces implémentations ont un point commun : le concept de dense retrieval. Un concept qui est au coeur de ce que les moteurs de recherche cherchent aujourd’hui à faire avec des LLMs et des embeddings pour améliorer leurs algorithmes.
Mais nous allons voir que le dense retrieval n’a pas totalement remplacé le parse retrieval, c’est à dire l’ancienne façon d’extraire des résultats pertinents dans les moteurs de recherche. Et comprendre les possibilités du « dense » et ses limites, mais aussi pourquoi l’ancienne approche a encore de l’intérêt, permet de bien comprendre quelles seront les évolutions des LLMs et des moteurs de recherche dans les prochaines années.
Dense retrieval : la définition
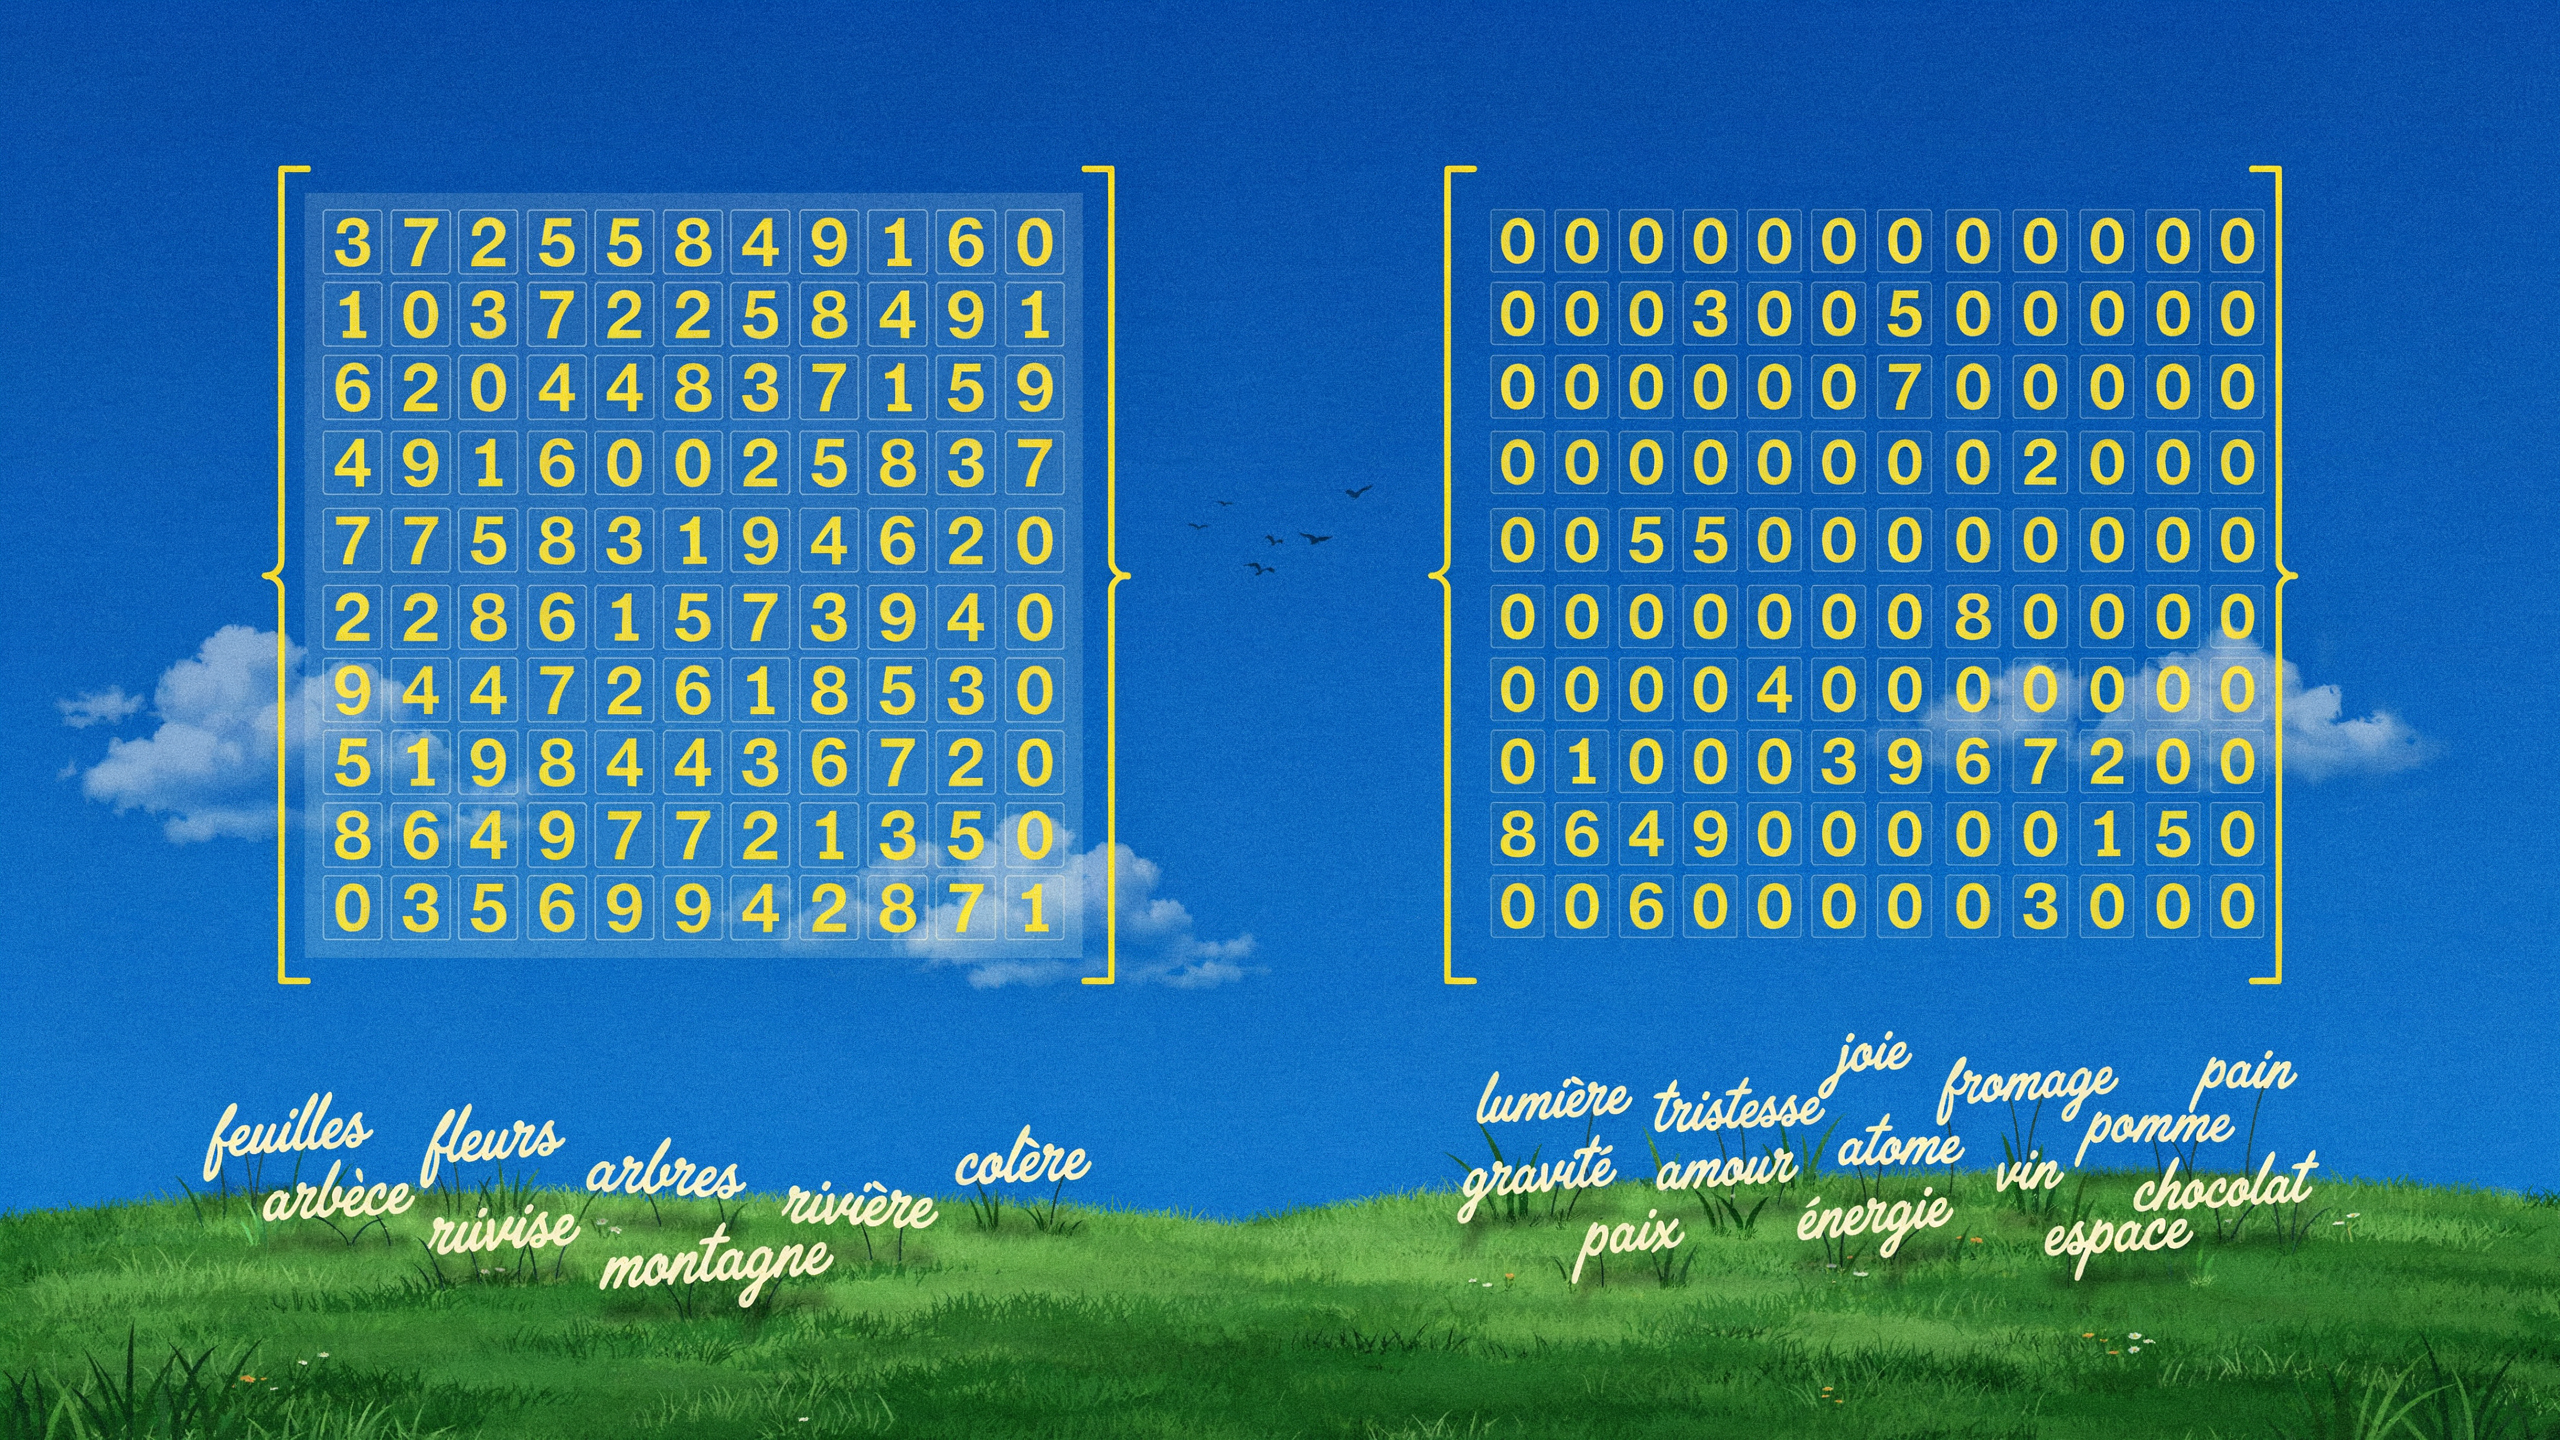
Le dense retrieval (recherche dense) est une méthode de recherche d’information qui retrouve les documents ayant le même sens que la question, même s’ils n’emploient pas les mêmes mots.
Le principe tient en trois étapes. Un modèle d’IA transforme chaque texte en une longue liste de nombres (des « vecteurs ») qui encode son sens. Ces nombres correspondent à des coordonnées dans un espace sémantique non pas à trois dimensions mais à n dimensions. Il fait de même avec la question. Le moteur retient ensuite les textes dont les coordonnées sont les plus proches de celles de la question.
Le mot retrieval (extraction en français) désigne l’étape de récupération : le moment où un moteur sélectionne, parmi des milliards de documents, les quelques centaines ou milliers de candidats qui seront ensuite classés, ou transmis à un modèle de langage pour rédiger une réponse. Le mot dense décrit la forme des listes de nombres utilisées dans les vecteurs, dont presque toutes les cases ont une valeur.
On l’oppose au sparse retrieval (recherche « creuse »), la méthode historique des moteurs de recherche, qui retrouve les documents contenant les mêmes mots que la question.
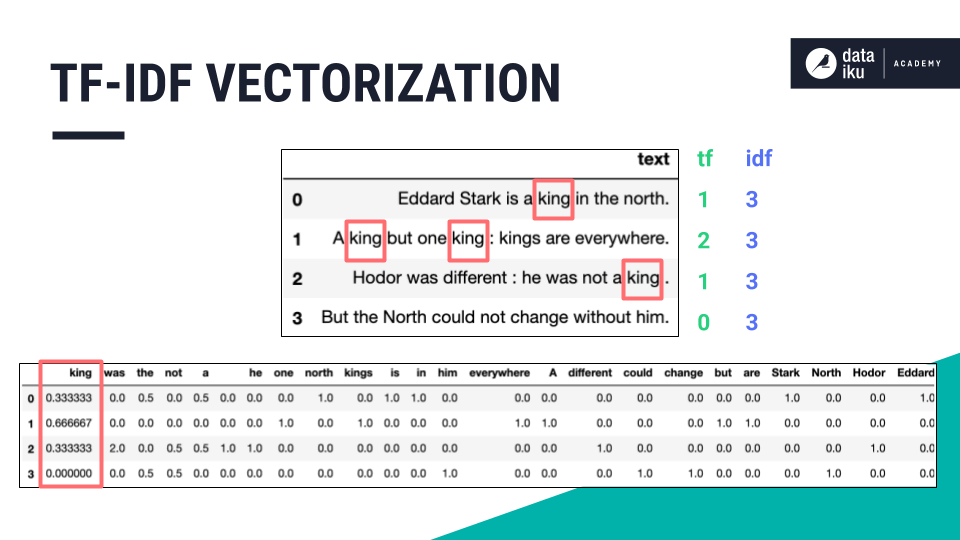
Des coordonnées proches indiquent une similarité lexicale, pas une similarité de sens. De plus, cela produit des vecteurs et des matrices « creuses » (parse), bourrés de zéros, ce qui rend les calculs moins efficaces. Source : https://knowledge.dataiku.com/latest/ml/complex-data/text/concept-text-features-for-ml.html
Les termes techniques à connaître
- Embedding : la liste (vecteur) de nombres qui représente le sens d’un texte. Elle compte généralement entre 384 et plusieurs milliers de valeurs. Deux textes au sens proche ont des embeddings proches.
- Vecteur : le terme mathématique pour une liste de nombres. On peut se le représenter comme les coordonnées d’un point dans un espace à n dimensions
- Encodeur : le modèle d’IA qui transforme un texte en embedding.
- Dual encoder (ou bi-encoder) : l’architecture standard du dense retrieval. Un encodeur traite la question, un autre traite les documents, et les deux produisent des vecteurs comparables.
- Similarité cosinus et produit scalaire : les deux calculs qui mesurent la proximité entre deux vecteurs. La similarité cosinus va de 0 (aucun rapport) à 1 (sens identique).
- TF-IDF et BM25 : les formules classiques du sparse retrieval. Elles notent un document selon le nombre de fois qu’il contient les mots de la question, en donnant plus de poids aux mots rares. BM25, publié par Stephen Robertson et ses collègues au milieu des années 1990, reste la référence. On retrouve les poids BM25 dans la plupart des implémentations de moteurs de recherche interne (SolR en particulier, mais chez beaucoup d’autres aussi).
- Index vectoriel et ANN (Approximate Nearest Neighbors) : la base qui stocke les embeddings de tous les documents, et l’algorithme qui y trouve en quelques millisecondes les points les plus proches d’une question. HNSW est l’algorithme ANN le plus répandu.
- Chunk : un passage de quelques paragraphes. Les moteurs découpent les pages en chunks, car un embedding résume mieux un sujet précis qu’une page entière.
- RAG (Retrieval-Augmented Generation) : le fonctionnement des moteurs de réponse IA, qui récupèrent d’abord des passages puis font rédiger la réponse par un LLM à partir de ces passages.
Le sparse retrieval : chercher par les mots
Pendant vingt ans, les moteurs ont fonctionné par correspondance de mots. Dans le compte rendu de l’appel du 31 janvier 2025, Pandu Nayak explique que la première approche de classement de Google ressemblait à Okapi BM25.
Le sparse retrieval représente chaque texte par un tableau qui comporte une case par mot du vocabulaire, soit des centaines de milliers de cases. Une case vaut zéro si le mot est absent du texte. Presque toutes valent donc zéro : c’est ce qui rend le vecteur « creux ». Le score d’un document dépend des cases non nulles qu’il partage avec la question.
Cette méthode est rapide, peu coûteuse et transparente : on sait toujours pourquoi un document est remonté. Mais elle a un défaut connu des chercheurs sous le nom de vocabulary mismatch : si la page dit la même chose que la question avec d’autres mots, elle obtient un score nul.
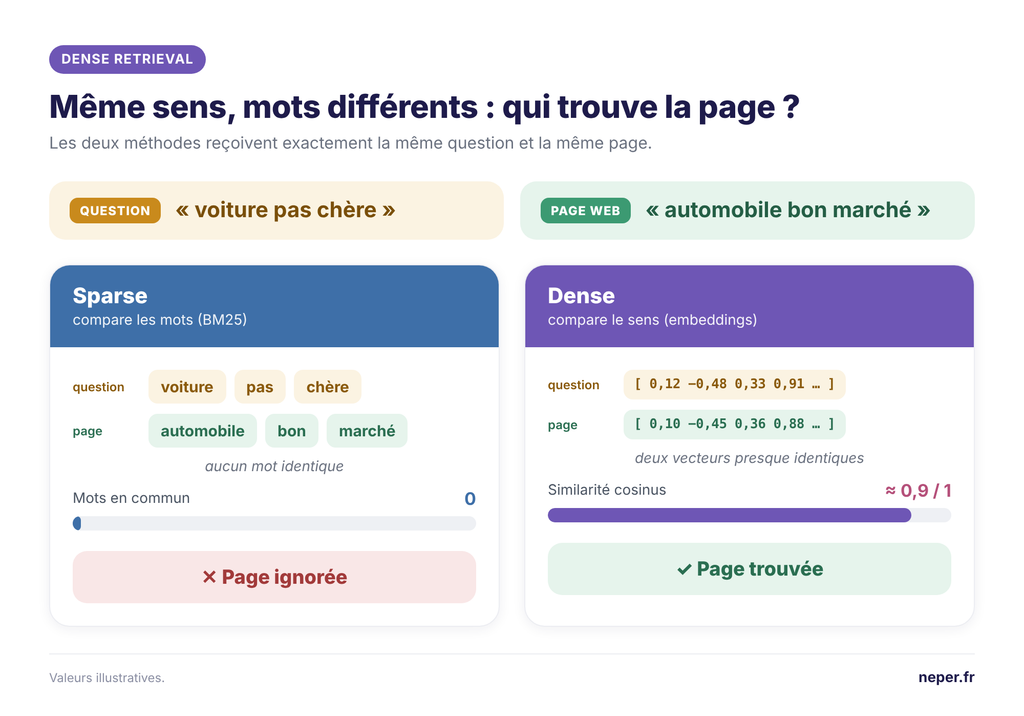
Même question, même page : la recherche par mots passe à côté, la recherche par sens la trouve. La similarité de 0,9 est une valeur illustrative.
Le dense retrieval : chercher par le sens
Le plus simple, pour comprendre le dense retrieval, est de l’imaginer comme une carte des idées. L’encodeur place chaque texte à un point de cette carte. Les textes qui traitent du même sujet se retrouvent voisins, quels que soient les mots employés. Pour répondre à une question, le moteur la place sur la carte et retient les pages les plus proches.
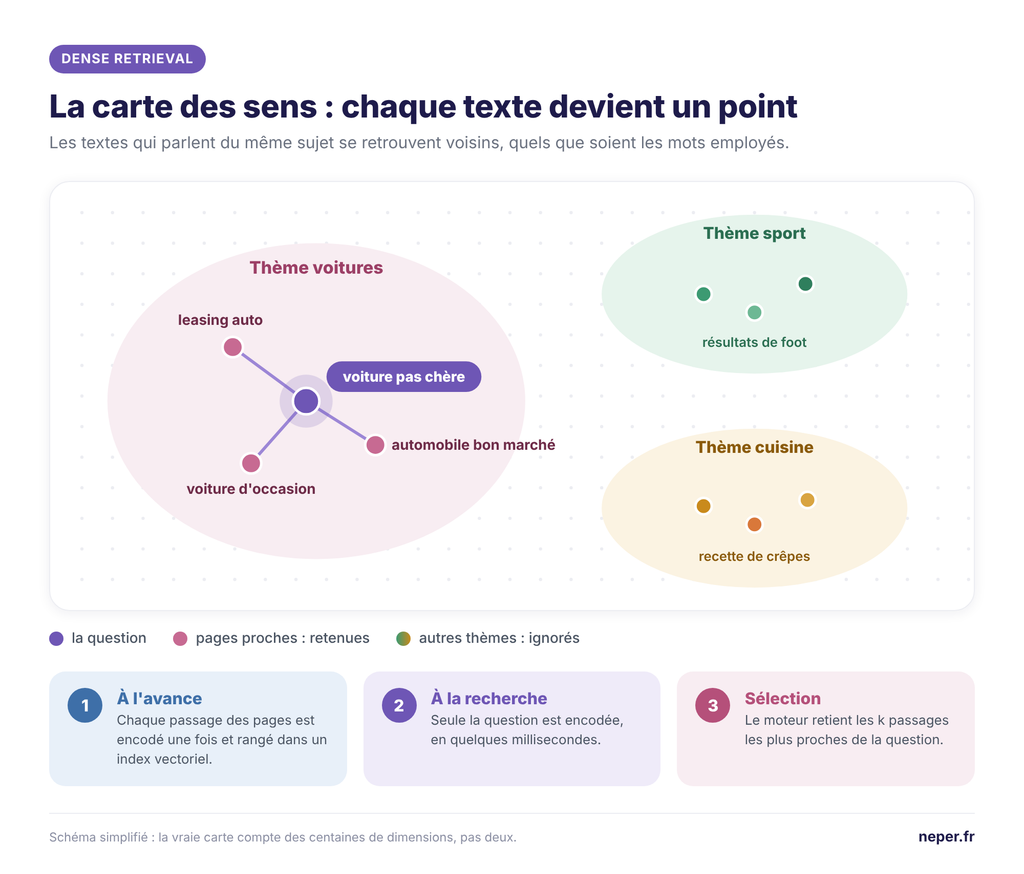
Chaque texte est un point. Proche signifie même sujet. La vraie carte compte des centaines de dimensions, pas deux.
Le travail se fait en deux temps. Les documents sont encodés une seule fois, à l’avance, découpés en chunks (morceaux), puis rangés dans un index vectoriel. Seule la question est encodée au moment de la recherche. Le moteur interroge alors l’index avec un algorithme ANN, qui renvoie les k passages les plus proches. C’est ce découpage qui permet de chercher parmi des millions de passages en quelques millisecondes.
Pandu Nayak décrit exactement ce schéma pour RankEmbed : la pertinence y est calculée comme un produit scalaire, c’est-à-dire une mesure de distance entre la question et le document dans l’espace des embeddings.
Ce que le dense apporte, chiffres à l’appui
La publication qui a installé la méthode date de 2020. Vladimir Karpukhin, Danqi Chen et Wen-tau Yih, alors chez Facebook AI, présentent Dense Passage Retrieval (DPR) à la conférence EMNLP en novembre 2020. Leur dual encoder est entraîné sur des paires question-passage.
Sur le jeu de données Natural Questions, composé de vraies requêtes Google, DPR place un passage contenant la bonne réponse parmi les 20 premiers résultats dans 78,4 % des cas, contre 59,1 % pour BM25. Sur l’ensemble des jeux testés, l’écart va de 9 à 19 points.
Les gains se concentrent sur quatre situations :
- les synonymes et reformulations, comme dans l’exemple « voiture » et « automobile » ;
- les questions longues formulées en phrase complète, typiques des chatbots, que BM25 réduit à une liste de mots ;
- les recherches multilingues, puisqu’un encodeur multilingue place « cheap car » et « voiture pas chère » au même endroit de la carte ;
- la recherche au niveau du passage, qui correspond exactement à l’unité qu’un système RAG transmet ensuite au LLM.
Là où les mots gardent l’avantage
Le même article de 2020 contient un résultat moins cité. Sur le jeu SQuAD, dont les questions reprennent souvent les mots exacts du texte source, BM25 obtient 68,8 % contre 63,2 % pour DPR. Et la combinaison des deux méthodes monte à 71,5 %.
En avril 2021, Nandan Thakur et Nils Reimers, à l’université technique de Darmstadt, publient le benchmark BEIR : 18 jeux de données et 10 systèmes de recherche testés hors de leur domaine d’entraînement. Leur conclusion : BM25 reste une référence robuste, et les modèles denses font souvent moins bien que lui dès qu’ils sortent des données sur lesquelles ils ont appris.
En août 2025, quatre chercheurs de Google DeepMind, dont Orion Weller et Jinhyuk Lee, vont plus loin. Ils démontrent que le nombre de combinaisons de documents qu’un embedding peut renvoyer est limité par sa taille. Sur leur jeu de test LIMIT, qui pose des questions aussi simples que « qui aime les pommes ? », les meilleurs modèles d’embeddings échouent, alors que BM25 frôle le score parfait. Le papier a été accepté à ICLR 2026.
Google le reconnaît lui-même : selon Pandu Nayak, RankEmbed est rapide et de bonne qualité sur les requêtes courantes, mais peut donner de mauvais résultats sur les requêtes de longue traîne.
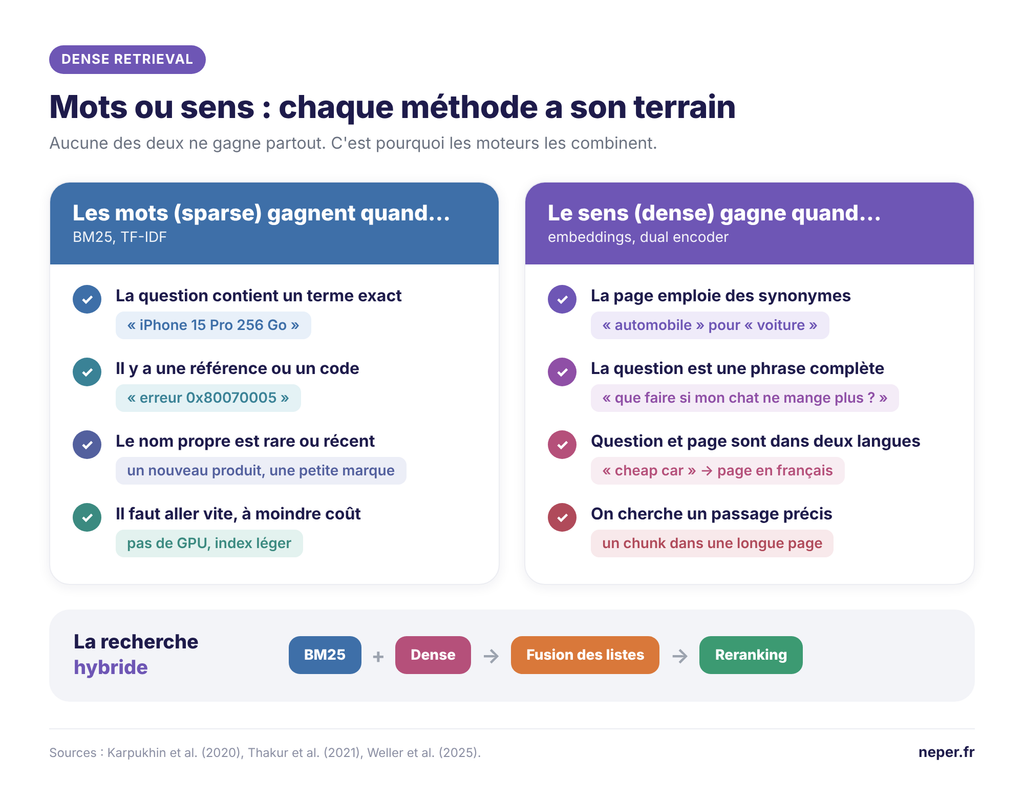
Les deux méthodes se complètent, d’où la recherche hybride.
C’est pourquoi les systèmes en production sont presque toujours hybrides : BM25 et dense tournent en parallèle, leurs listes sont fusionnées, puis un reranker trie les meilleurs candidats.
Chez Google : de neural matching à RankEmbed
Google applique ce principe au moteur classique depuis des années. Dans un billet publié le 3 février 2022, Pandu Nayak retrace la chronologie : RankBrain en 2015, premier système de deep learning du moteur, puis neural matching en 2018. Il présente ce dernier comme une pièce essentielle de la façon dont Google récupère les documents pertinents, en rapprochant les concepts de la requête et ceux de la page. C’est la définition même du dense retrieval appliquée à la recherche web.
Les documents du procès antitrust ajoutent deux précisions. D’abord, RankEmbed a été entraîné sur un échantillon d’un seul mois de données de recherche. Ensuite, Google a constaté qu’en combinant les signaux traditionnels et ceux prédits par ses modèles de deep learning, il obtenait de meilleurs résultats qu’avec l’une ou l’autre famille seule. Le moteur de Google est donc lui aussi hybride.
Le compte rendu précise enfin que FastSearch, construit sur RankEmbed, est le mécanisme de RAG que Google utilise pour Gemini et Vertex AI. Autrement dit, la sélection des pages qui nourrissent les réponses de Gemini repose sur un dual encoder, donc sur une proximité d’embeddings entre la question et le document. Google ne publie pas le détail de la chaîne utilisée par AI Overviews et AI Mode. Le principe de récupération par le sens y est probable, mais il n’est pas confirmé par une source primaire.
Pourquoi ça compte, et ce que vous devez faire
Dans un moteur de réponse, un passage qui n’est pas récupéré à l’étape du retrieval ne peut pas être cité, quelle que soit sa qualité.
Le dense retrieval ne classe pas des pages : il compare des chunks à une question.
Le risque concret est double. Un contenu bien positionné sur ses mots-clés peut être absent des réponses IA si ses passages sont mal formés. À l’inverse, un contenu optimisé uniquement « pour le sens » peut perdre les requêtes précises, que les composants lexicaux des systèmes hybrides continuent de traiter.
Bref, selon les typologies de requêtes, les optimisations efficaces sont celles qui ciblent les couches « parse » ou « dense ». Et il faut garder cela en tête : à ne faire que du « GEO », vous risquez de ne pas être dans les résultats sortis par le vieil algo. Et dans tous les LLMs aujourd’hui, les systèmes de grounding sont hybrides, pour des raisons de coût et de performance.
Sources
- Department of Justice, exhibit PXR0357 : January 31, 2025 Call with Google Engineer Pandu Nayak (PDF)
- Google, Pandu Nayak : How AI powers great search results (3 février 2022)
- Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, EMNLP 2020
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021
- Weller et al., Google DeepMind, On the Theoretical Limitations of Embedding-Based Retrieval, ICLR 2026
- Neper : Le chunking, comment rédiger des contenus optimisés pour le GEO et le SEO
- Neper : Optimisation pour Perplexity, anatomie d’une source citée
Ce contenu vous a plu ?
Inscrivez-vous gratuitement à notre newsletter et recevez chaque semaine l’actualité du SEO directement dans votre boîte email. Vous pouvez vous désabonner à tout moment !