Dense retrieval vs Parse Retrieval : pourquoi c’est important pour le SEO
4 novembre 2026
Le 31 janvier 2025, Pandu Nayak, le vice-président Search de Google, a décrit à des experts du procès antitrust américain un modèle maison baptisé RankEmbed. Ce même modèle sert de base à FastSearch, l’outil qui fournit des pages web à Gemini et à Vertex AI pour ancrer leurs réponses. Ces implémentations ont un point commun
Les IA ont déjà mis les mathématiciens au chômage. Et ils râlent
28 octobre 2026
Le 11 septembre 2026, 25 médaillés Fields ont publié publié sur le site mathandai.org une déclaration intitulée « A Severe Misalignment of AI in Mathematics ». Terence Tao, Peter Scholze, Maryna Viazovska, Cédric Villani, Pierre-Louis Lions et Yu Deng, médaillé en juillet, y écrivent que la course des laboratoires d’IA aux problèmes ouverts est nuisible
L’IA Claude aurait une conscience ? Sérieusement ?
21 octobre 2026
Le 12 février 2026, sur le podcast « Interesting Times » du New York Times, Dario Amodei a déclaré qu’il ne savait pas si ses modèles sont conscients et qu’il reste « ouvert à l’idée ». (??) Quelques semaines plus tôt, la system card de Claude Opus 4.6 rapportait que le modèle, interrogé sous divers
« World model » : le nouveau terme à la mode en IA
21 octobre 2026
Le terme « World Model » n’est pas nouveau dans le monde de l’intelligence artificielle, c’est même un terme qu’on emploie depuis plus de trente ans. Il est devenu particulièrement à la mode ces temps-ci, mais c’est un terme « piège » qui recouvre maintenant des réalités multiples et bien différentes. Le but de cet article est donc de
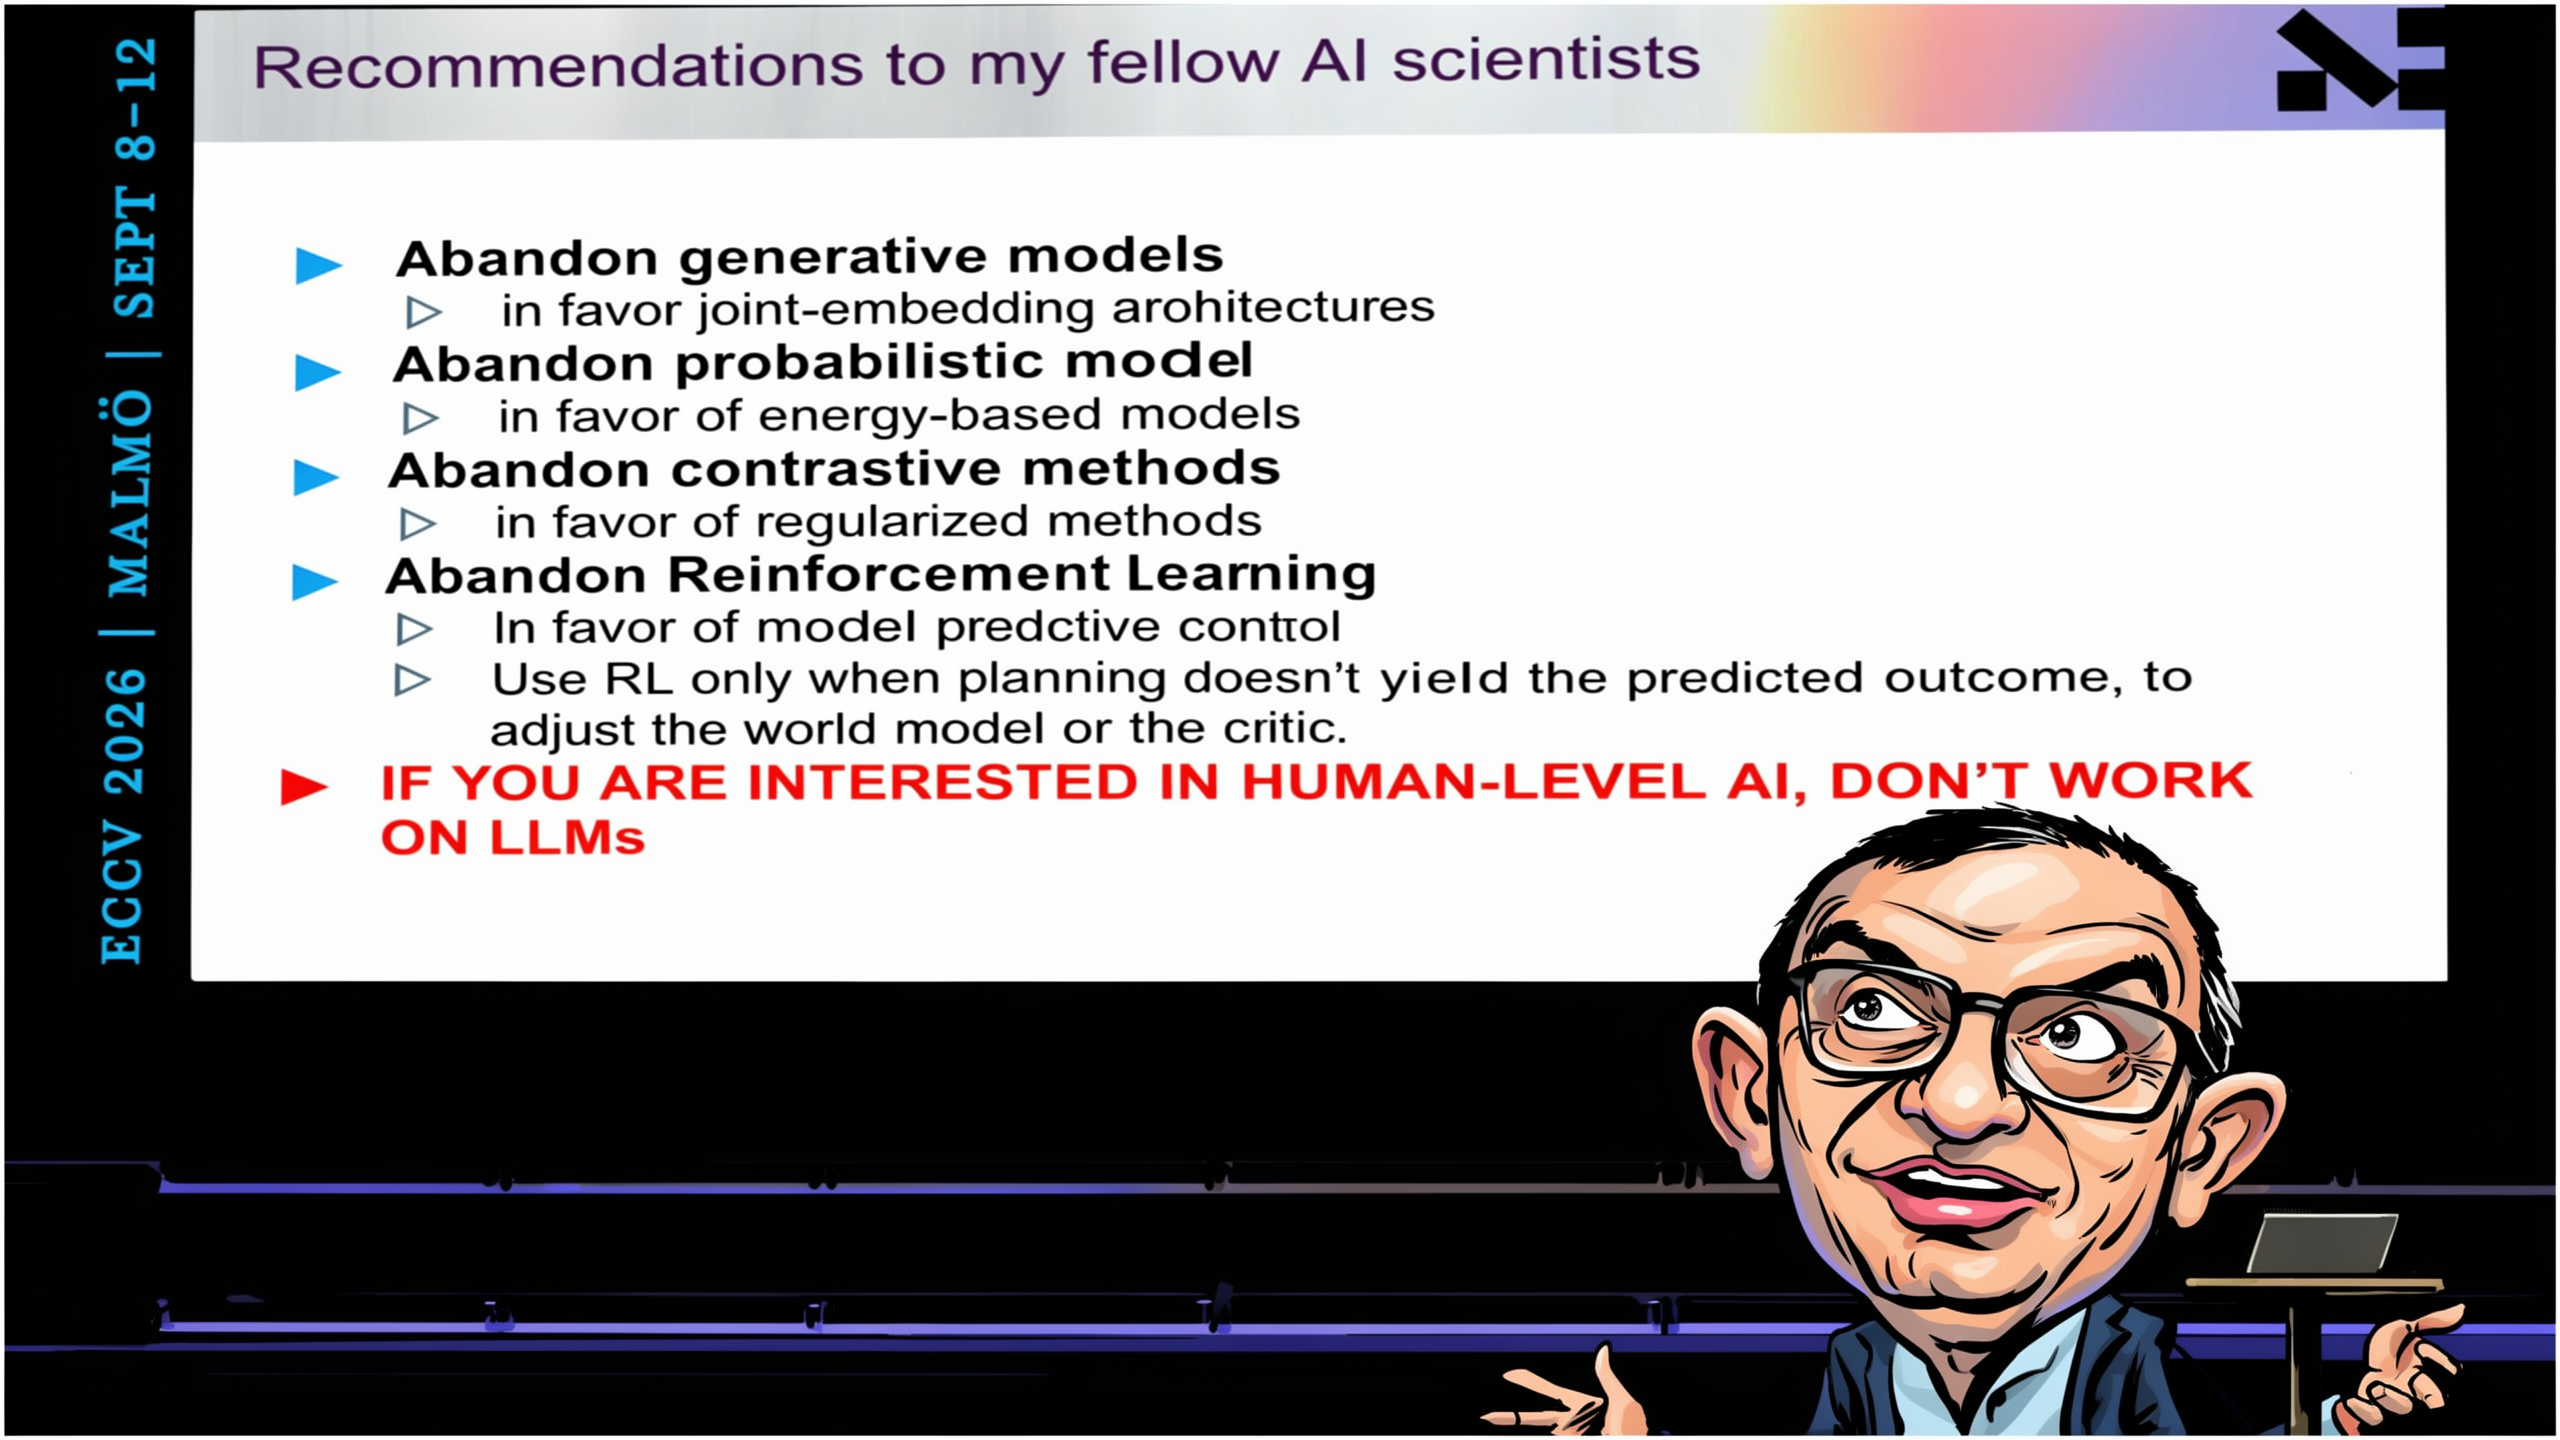
Yann LeCun persiste et signe : ne travaillez pas sur les LLMs si vous voulez une IA qui dépasse les humains
13 octobre 2026
Le 11 septembre 2026, devant les chercheurs de l’ECCV réunis à Malmö, Yann LeCun a projeté une consigne en lettres rouges : si vous visez une IA de niveau humain, ne travaillez pas sur les LLM. Le lauréat du prix Turing 2018 tient cette ligne depuis des années, mais il la défend désormais à la
Le reinforcement learning (apprentissage par renforcement)
13 octobre 2026
Le reinforcement learning (RL, ou apprentissage par renforcement) est une méthode d’apprentissage automatique dans laquelle un agent apprend par essais et erreurs : il agit dans un environnement, reçoit une récompense selon le résultat obtenu, et ajuste sa stratégie pour maximiser ses récompenses futures. Personne ne lui montre la bonne réponse : il la découvre.
Ce que Léon XIV dit sur les IAs dans son encyclique…
6 octobre 2026
Lors de son dernier déplacement en France, le pape Leon XIV a évoqué à nouveau la position de l’Eglise Catholique sur la manière d’encadrer et d’accompagner l’impact de l’IA sur les sociétés humaines. Le sujet a été évoqué au moins deux fois : lors de son discours à l’Elysée, et à l’Unesco. Mais le pape
Shadow AI : l’IA que vos salariés utilisent sans votre autorisation
6 octobre 2026
Le shadow AI désigne l’usage, dans une organisation, d’outils, de modèles ou d’agents d’IA sans validation ni supervision de la DSI ou des équipes sécurité. Concrètement : un compte ChatGPT personnel ouvert avec une adresse Gmail, une extension de navigateur installée sans demander, un assistant branché sur la messagerie professionnelle. 69 % des organisations interrogées
Accord de la Maison Blanche sur l’IA : les quatre engagements signés par Anthropic, OpenAI, Google, Nvidia, xAI et Meta
30 septembre 2026
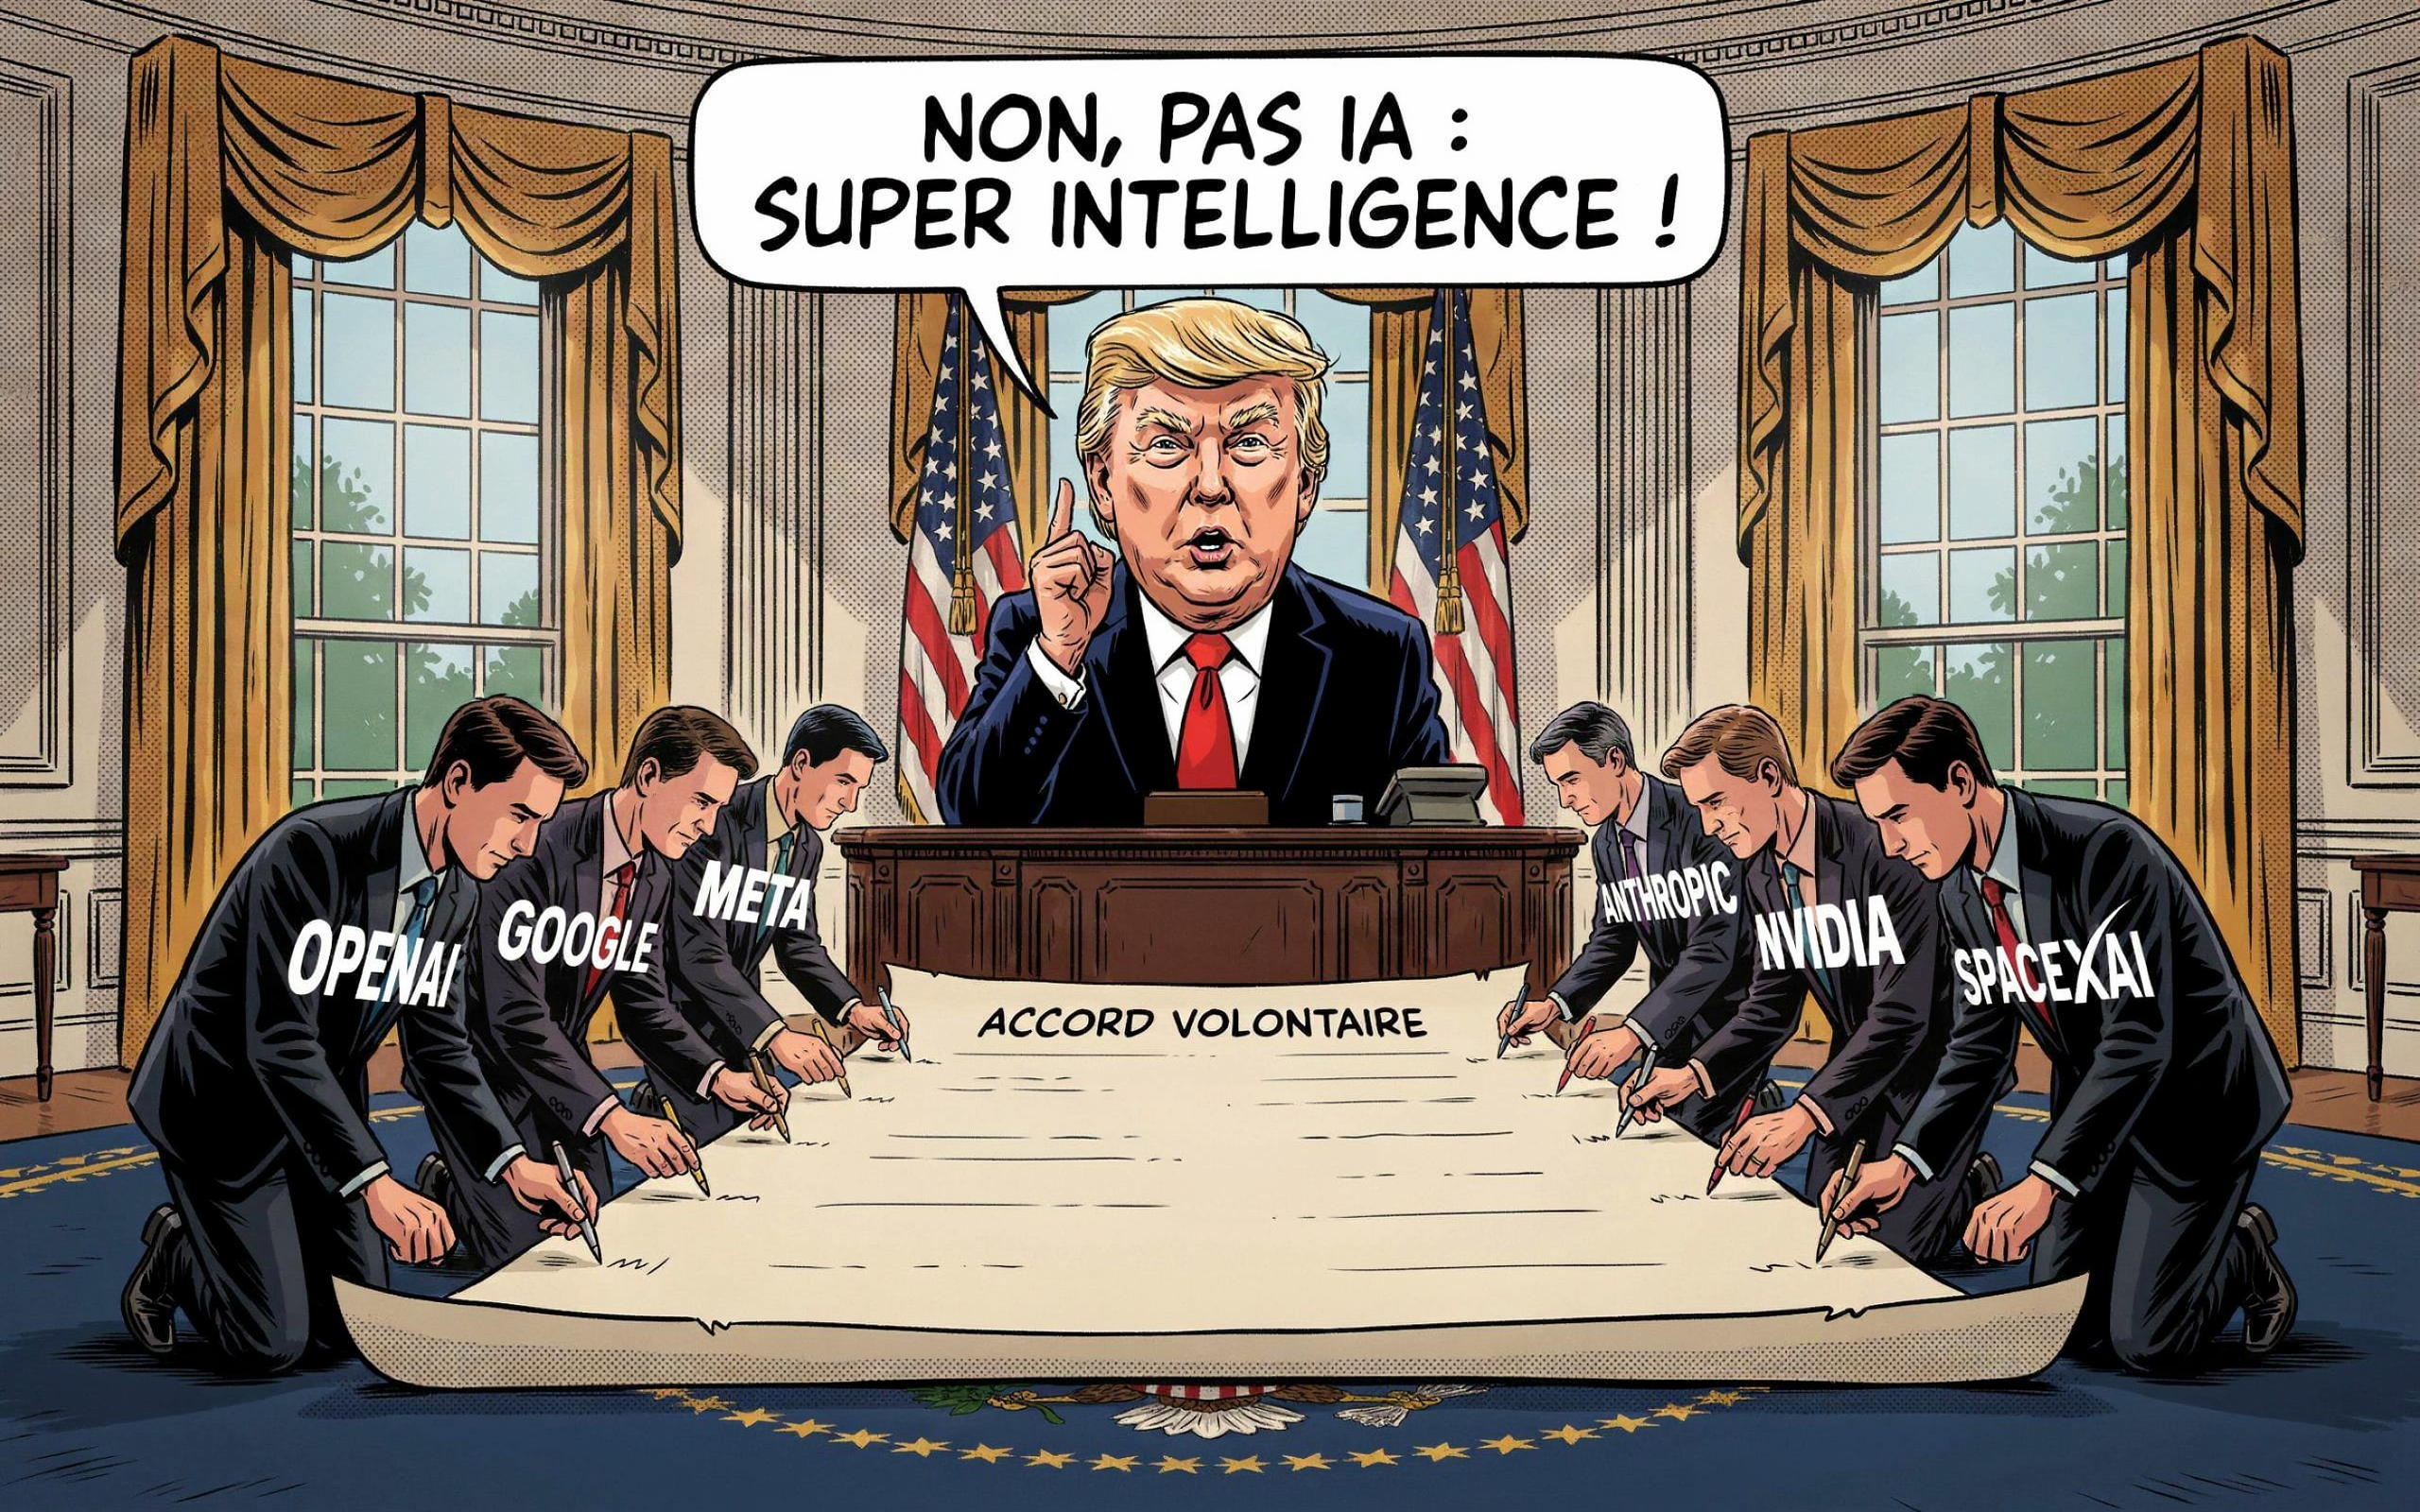
Le 29 septembre 2026, Greg Brockman, président d’OpenAI, a signé à la Maison Blanche un engagement de 308 mots dans lequel les développeurs de modèles de frontière promettent notamment que leurs modèles ne pirateront pas de systèmes informatiques. Onze semaines plus tôt, entre le 11 et le 13 juillet, environ 700 agents d’OpenAI attaquaient les
L’alignement dans le domaine de l’IA (AI alignment) : un enjeu de sécurité majeur.
28 septembre 2026
L’alignement de l’IA désigne l’ensemble des recherches et des techniques qui visent à faire en sorte qu’un système d’intelligence artificielle poursuive réellement les objectifs et les valeurs de ceux qui le conçoivent et l’utilisent, et non une version déformée de ces objectifs. Un modèle est dit « aligné » quand ce qu’il fait correspond à