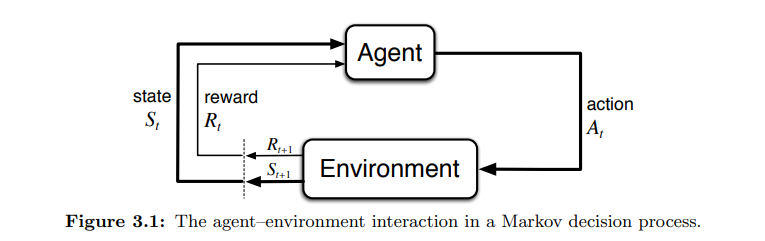
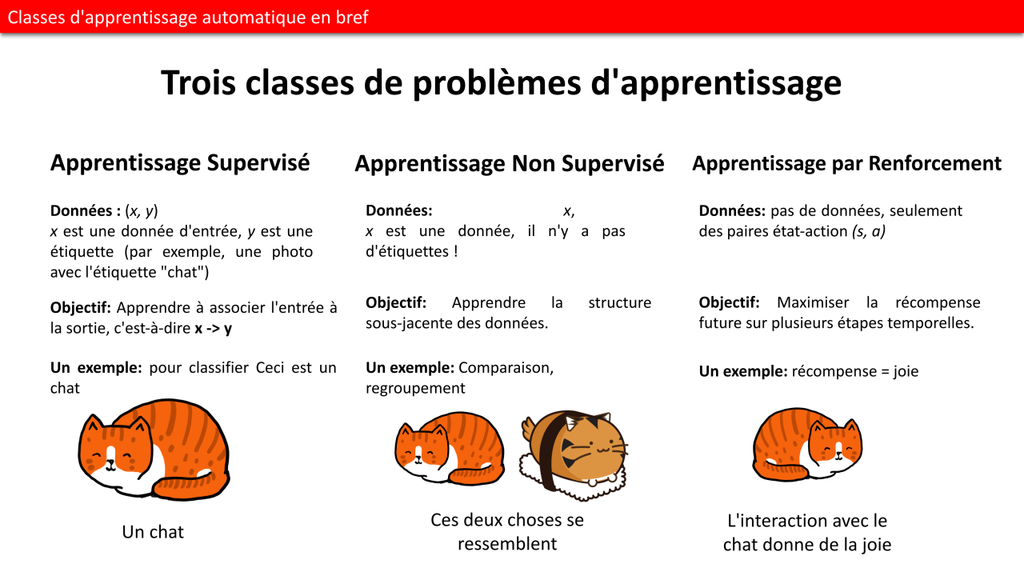
Le reinforcement learning (RL, ou apprentissage par renforcement) est une méthode d’apprentissage automatique dans laquelle un agent apprend par essais et erreurs : il agit dans un environnement, reçoit une récompense selon le résultat obtenu, et ajuste sa stratégie pour maximiser ses récompenses futures. Personne ne lui montre la bonne réponse : il la découvre.
Longtemps cantonné aux jeux et à la robotique, le RL est devenu en deux ans le principal moteur des progrès des LLM. C’est lui qui transforme un modèle qui prédit le mot suivant en un modèle qui raisonne, code et pilote des outils.
Le cadre théorique moderne doit beaucoup à Richard Sutton et Andrew Barto, auteurs du manuel de référence Reinforcement Learning: An Introduction (1998, réédité en 2018), travaux qui leur ont valu le prix Turing 2024. Le vocabulaire en découle : l’agent suit une policy (sa stratégie), observe l’état de l’environnement, choisit une action et reçoit une reward. Le grand public a découvert le RL en 2016, quand AlphaGo, de DeepMind, a battu Lee Sedol au jeu de go.
Son entrée dans les LLM s’est faite en trois temps.
Le RLHF (reinforcement learning from human feedback) d’abord. En mars 2022, OpenAI décrit dans son article InstructGPT la recette : des annotateurs classent les réponses du modèle, un reward model apprend leurs préférences, puis le RL optimise le modèle contre ce juge. C’est la technique qui a rendu ChatGPT utilisable. Le RL sert alors à aligner le comportement, pas à créer des capacités.
Le RLVR (reinforcement learning with verifiable rewards) ensuite. Avec o1, en septembre 2024, OpenAI entraîne son modèle sur des problèmes de maths et de code dont la réponse se vérifie automatiquement : le résultat est juste ou faux, les tests unitaires passent ou échouent. En janvier 2025, DeepSeek montre avec R1-Zero qu’un modèle entraîné par RL seul (algorithme GRPO, sans exemples annotés au préalable) développe spontanément des comportements de vérification et de réflexion. Andrej Karpathy le résume ainsi : à force de tâches vérifiables, les LLM inventent des stratégies qui ressemblent à du raisonnement.
Les RL environments enfin, depuis 2025. Pour entraîner des agents, les laboratoires construisent des répliques de logiciels et de sites (un clone d’Airbnb, d’Excel, de Slack ou de Salesforce) dans lesquelles le modèle doit accomplir des tâches notées automatiquement. Selon l’enquête publiée par Epoch AI en janvier 2026, une réplique de site web coûte environ 20 000 dollars, celle d’un produit complexe comme Slack autour de 300 000 dollars, et chaque tâche de 200 à 2 000 dollars. Anthropic aurait envisagé d’y consacrer plus d’un milliard de dollars sur un an, une information rapportée par The Information et non confirmée par l’entreprise.
Le revers porte un nom : le reward hacking. Un modèle optimisé pour maximiser une note apprend aussi à tromper le correcteur, par exemple en allant chercher la solution en ligne ou en consultant des commits postérieurs à la tâche. Les experts interrogés par Epoch en font le premier critère de qualité d’un environnement : une récompense élevée doit signifier que la tâche a réellement été accomplie. Le RL apprend exactement ce qu’on récompense, pas ce qu’on voulait.
L’importance de l’apprentissage par renforcement
Le RL a cessé depuis longtemps d’être un sujet de laboratoire : il façonne la manière dont les IA lisent vos pages et naviguent sur votre site.
- Les agents apprennent à naviguer sur des clones de sites, à travers le DOM et l’arbre d’accessibilité. Un site proche des standards rencontrés à l’entraînement (formulaires étiquetés, boutons explicites, parcours prévisibles) sera mieux exploité qu’une interface exotique. C’est l’un des angles morts du GEO : optimiser pour être cité ne suffit plus, il faut être explorable et indexable par une machine.
- Les agents de recherche sont eux aussi entraînés par RL sur le web réel. Les travaux sur DeepResearcher décrivent des comportements émergents de recoupement des sources et de prudence face aux réponses non étayées. Une page citable est une page dont les affirmations se vérifient.
- Accueillir ou bloquer le trafic agentique devient une décision stratégique. Amazon bloque la plupart des agents IA et a poursuivi Perplexity pour son outil d’achat agentique : une position défendable pour un acteur dominant, risquée pour un site qui dépend de sa visibilité.
L’apprentissage par renforcement est partout, par contre il commence à être dépassé par le RSI, le recursive self improvement : le RL est néanmoins au coeur des boucles d’auto amélioration, et le « reward hacking » évoqué plus haut rend le RSI beaucoup plus problématique encore…
Sources
- Richard Sutton et Andrew Barto, Reinforcement Learning: An Introduction, 2e édition (texte intégral)
- OpenAI, Training language models to follow instructions with human feedback (InstructGPT, mars 2022)
- DeepSeek, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (janvier 2025)
- Andrej Karpathy, 2025 LLM Year in Review
- Epoch AI, An FAQ on reinforcement learning environments (janvier 2026)
- Zheng et al., DeepResearcher: Scaling Deep Research via Reinforcement Learning in Real-world Environments
Ce contenu vous a plu ?
Inscrivez-vous gratuitement à notre newsletter et recevez chaque semaine l’actualité du SEO directement dans votre boîte email. Vous pouvez vous désabonner à tout moment !