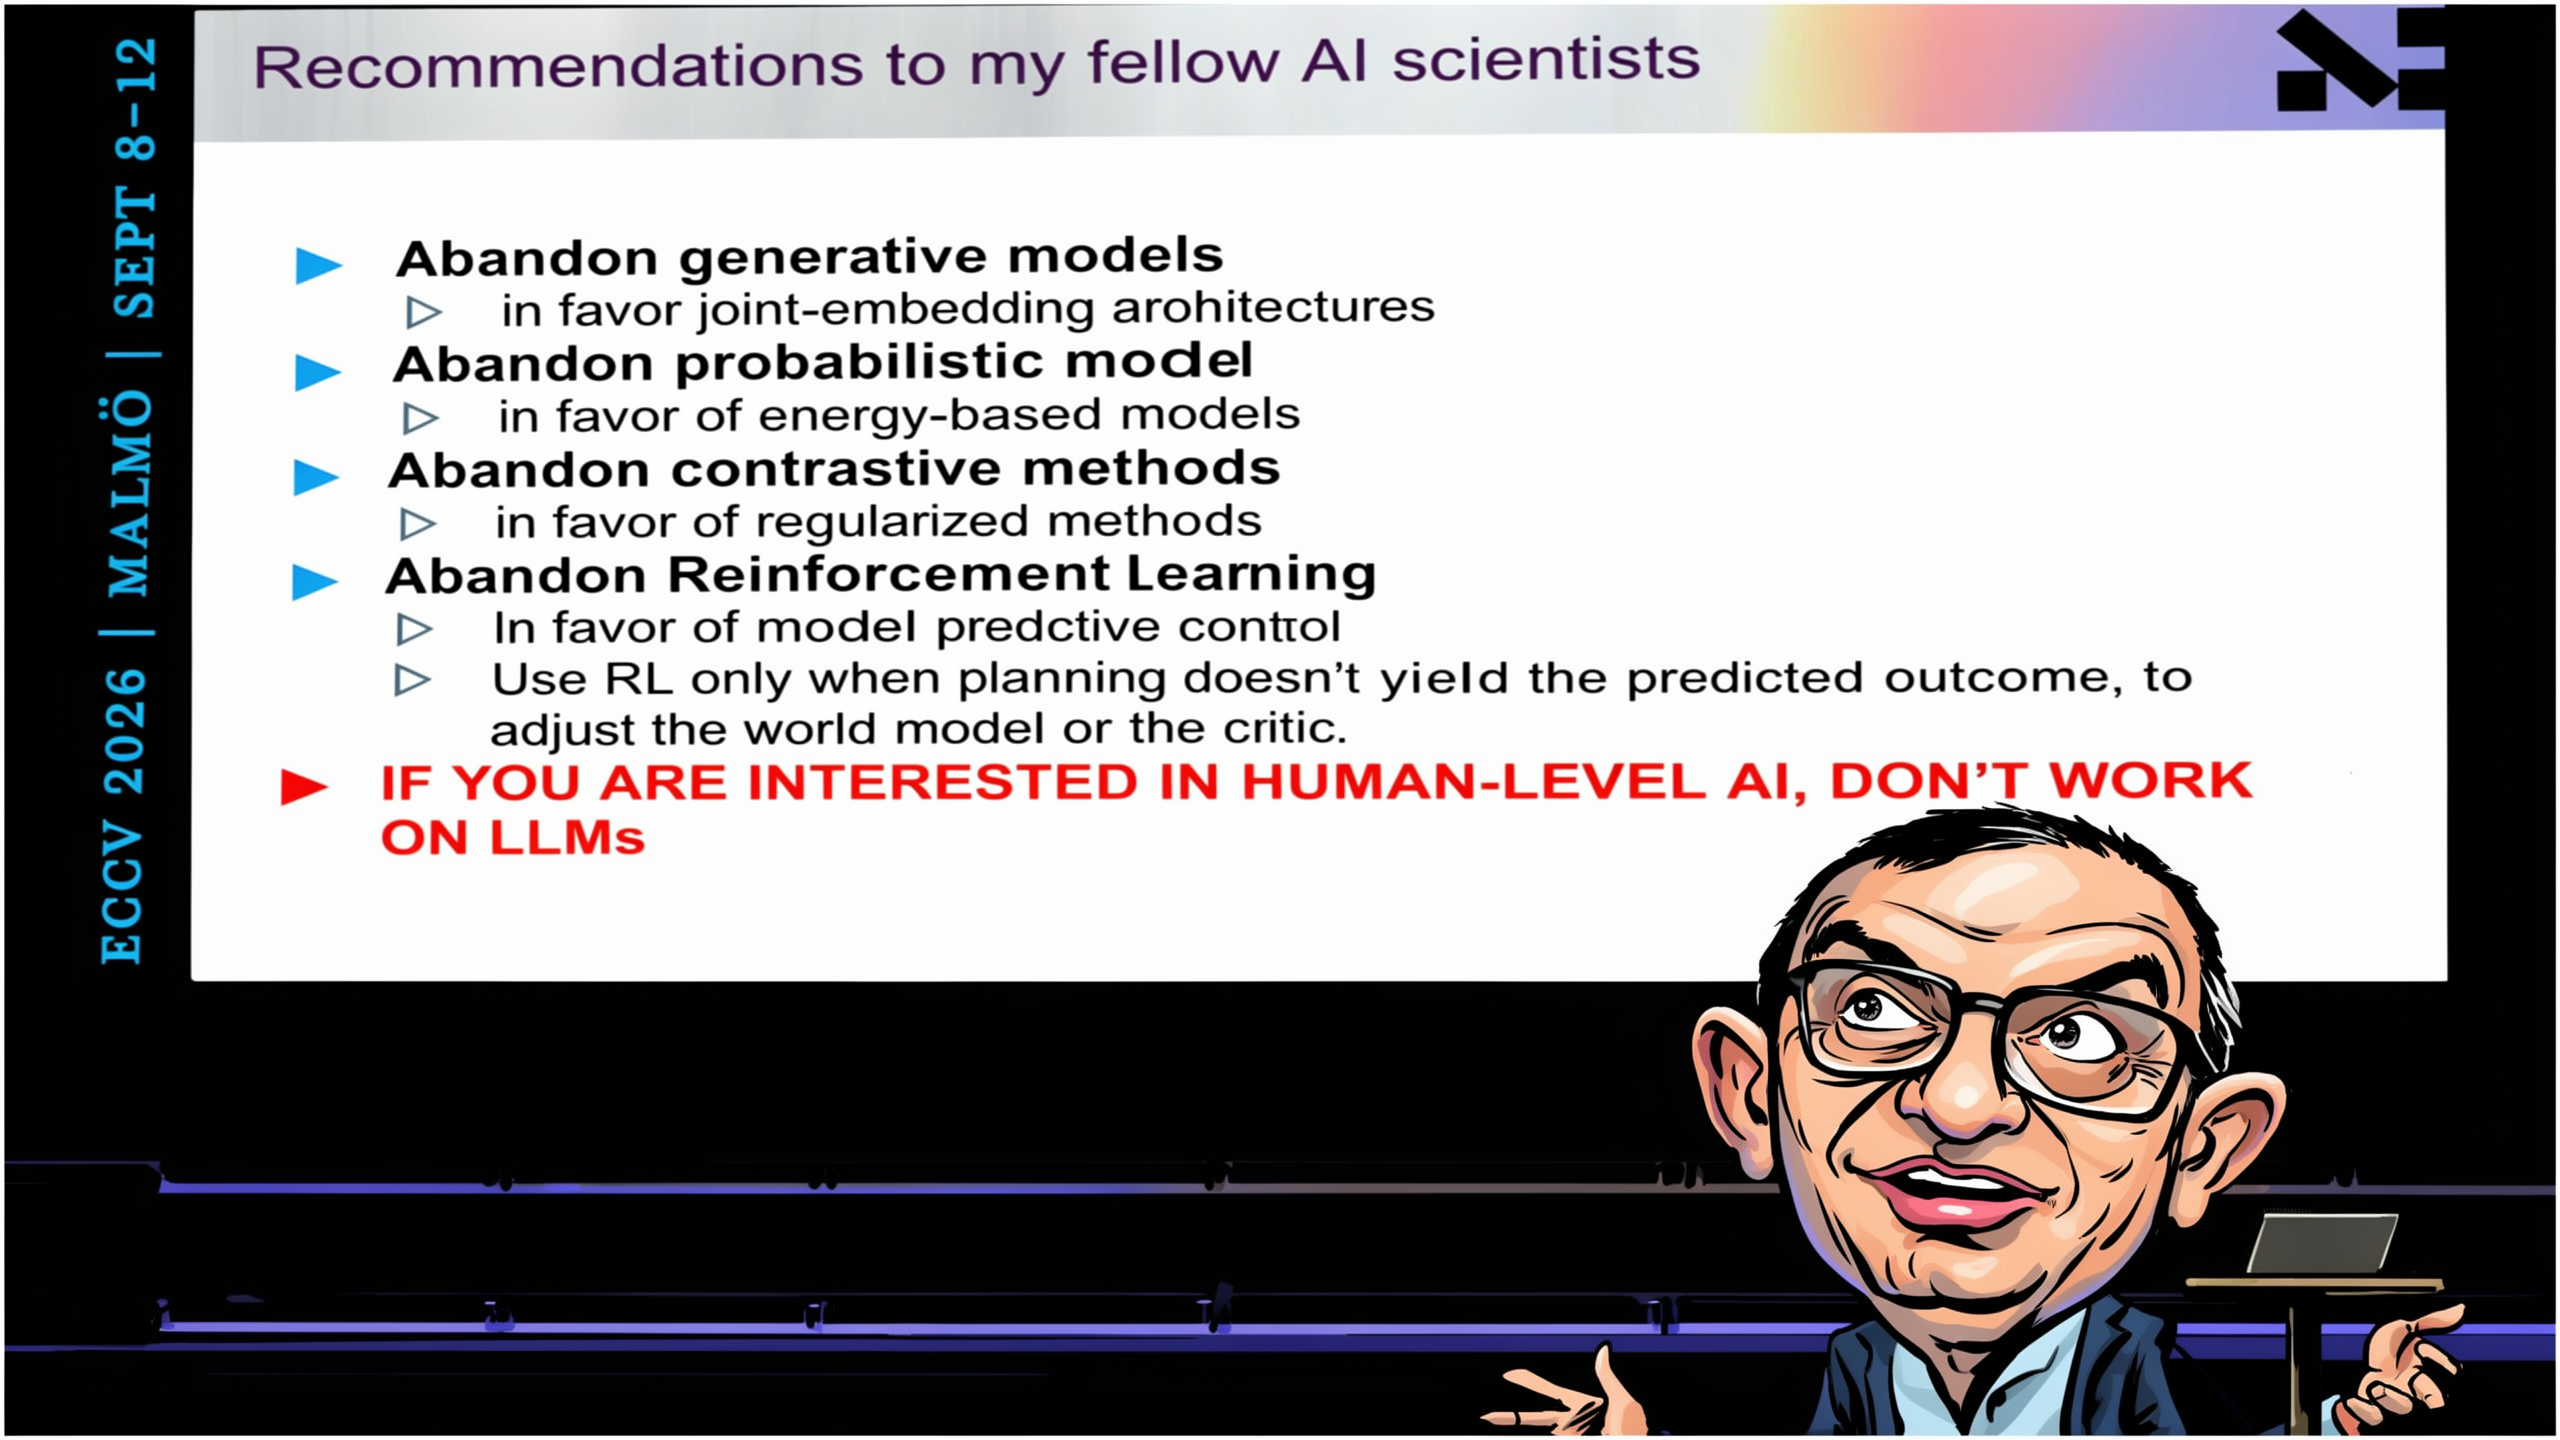
Le 11 septembre 2026, devant les chercheurs de l’ECCV réunis à Malmö, Yann LeCun a projeté une consigne en lettres rouges : si vous visez une IA de niveau humain, ne travaillez pas sur les LLM.
Le lauréat du prix Turing 2018 tient cette ligne depuis des années, mais il la défend désormais à la tête d’AMI Labs, une start-up parisienne qui a levé 1,03 milliard de dollars en mars pour construire l’alternative.
Sur le diagnostic, il n’est plus isolé : Google DeepMind, Nvidia et World Labs misent eux aussi sur les world models, des modèles qui simulent l’évolution du monde physique. Le vrai désaccord porte sur la méthode.
Qui est Yann LeCun, et pourquoi on l’écoute quand il parle d’IA
Diplômé de l’ESIEE en 1983, docteur de l’université Pierre et Marie Curie en 1987, Yann LeCun rejoint les Bell Labs d’AT&T en 1988. C’est là qu’il met au point les réseaux de neurones convolutifs, l’architecture qui a rendu possible la reconnaissance d’images moderne, de la lecture automatique des chèques aux véhicules autonomes. En 2018, il reçoit le prix Turing avec Geoffrey Hinton et Yoshua Bengio, pour leurs travaux sur le deep learning.
Professeur à NYU depuis 2003, il fonde en 2013 le laboratoire FAIR de Facebook, puis devient Chief AI Scientist de Meta de 2018 à 2025. Pendant cette période, Meta publie Llama, l’une des familles de LLM open source les plus utilisées au monde. LeCun critique donc une technologie que son propre laboratoire a contribué à populariser.
Fin 2025, il quitte Meta. Le 10 mars 2026, il annonce AMI Labs (Advanced Machine Intelligence, prononcé comme le mot français). La société lève 1,03 milliard de dollars pour une valorisation de 3,5 milliards avant l’opération, auprès d’investisseurs parmi lesquels Nvidia et Bezos Expeditions. Le siège est à Paris, avec des antennes à New York, Montréal et Singapour.
LeCun en est le président exécutif. La direction générale revient à Alexandre LeBrun, fondateur de la start-up de santé Nabla, qui devient le premier partenaire commercial d’AMI. Saining Xie dirige la science, Michael Rabbat la recherche sur les world models. LeBrun prévient lui-même que la technologie mettra des années à passer du laboratoire au produit.
Mais notons au passage que Yann Lecun a un agenda à peine caché : AMI labs travaille sur cette nouvelle approche qu’il prône à chaque fois qu’on lui en donne l’occasion. En même temps, ce qu’il dit à Malmö, il le répète depuis des années, c’est à dire bien avant de lancer son entreprise.
Ce n’est pas une nouvelle lubie, ni une posture opportuniste : Yann LeCun pense que les LLMs sont une impasse pour créer une AGI (une intelligence artifielle capable de performer dans tous les domaines) et (on peut rêver) un androïde capable de desservir la table, garder vos enfants ou réparer votre moto.
Ce que LeCun reproche aux LLM
Un LLM apprend à prédire le token suivant dans une séquence de texte.
Pour LeCun, cette méthode atteint un plafond pour une raison qui tient à la nature du signal exploité.
Le texte est un espace discret : à chaque étape, le modèle choisit parmi un vocabulaire fini de quelques dizaines de milliers de tokens, et peut attribuer une probabilité à chacun. La vidéo ne se prête pas à ce traitement. Le nombre d’images possibles après une image donnée est si grand qu’il est impossible de les énumérer, et la plupart de leurs détails sont imprévisibles : la position exacte de chaque feuille d’un arbre dans le vent, le reflet sur une vitre.
Or c’est par l’observation du monde physique, pas par la lecture, qu’un enfant apprend la gravité ou la permanence des objets. Un système entraîné sur du texte hérite de ce que les humains ont écrit sur le monde, pas d’un modèle de son fonctionnement. D’où les erreurs de bon sens physique que les LLM commettent encore, et leur difficulté à planifier une séquence d’actions dont ils prévoient les conséquences.
Le slide de Malmö traduit ce diagnostic en quatre consignes adressées aux chercheurs :
- abandonner les modèles génératifs au profit des joint-embedding architectures ;
- abandonner les modèles probabilistes au profit des energy-based models ;
- abandonner les méthodes contrastives au profit des méthodes régularisées ;
- abandonner le reinforcement learning (apprentissage par renforcement) au profit du model-predictive control, en ne gardant le RL que pour corriger le modèle quand la planification échoue.
La cible n’est donc pas les LLM en tant que produits. LeCun ne conteste pas leur utilité pour le texte. Il conteste qu’on puisse, en les agrandissant, obtenir une intelligence capable d’agir dans le monde réel.
Le world model, nouveau point de convergence
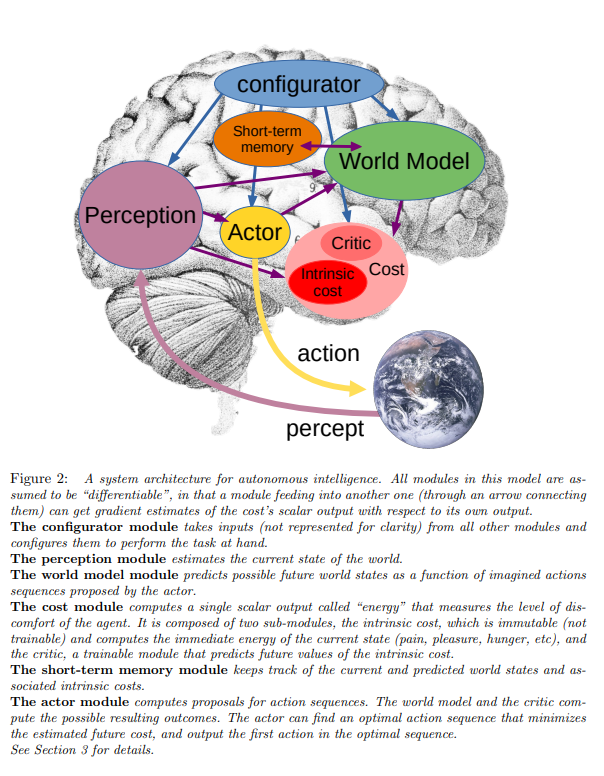
Sur ce point, LeCun a cessé d’être un dissident. Un world model est un modèle interne qui prédit comment l’environnement va évoluer, en particulier sous l’effet des actions de l’agent. Il permet de simuler mentalement un geste avant de l’exécuter. L’idée vient de la théorie du contrôle, et LeCun l’a formalisée pour l’IA dans un texte de juin 2022, A Path Towards Autonomous Machine Intelligence.
Trois ans plus tard, les principaux laboratoires ont rejoint le mouvement :
- Nvidia présente Cosmos au CES de janvier 2025, une famille de modèles destinés à la robotique et à la conduite autonome, entraînée selon l’entreprise sur 20 millions d’heures de vidéo ;
- Google DeepMind publie Genie 3 le 5 août 2025, un modèle qui génère en temps réel des mondes navigables en 720p à 24 images par seconde. Ses auteurs, Jack Parker-Holder et Shlomi Fruchter, qualifient les world models de « key stepping stone on the path to AGI » ;
- World Labs, la société de Fei-Fei Li, lance Marble, qui produit des environnements 3D éditables.
Même Eric Xing, président de l’université MBZUAI, qui a débattu publiquement avec LeCun en mai 2026, s’accorde avec lui sur l’essentiel : dépasser les modèles de langage exige des systèmes capables de raisonner par simulation. Ce qui les sépare, c’est la forme que doit prendre cette simulation.
Générer le monde ou l’abstraire : la vraie ligne de fracture
Genie 3, Cosmos et Marble sont des world models génératifs. Ils prédisent l’observation elle-même : l’image suivante, pixel par pixel, ou la scène 3D complète. Quand un agent agit dans Genie 3, le modèle produit la vidéo de ce qui se passe ensuite.
LeCun défend l’approche inverse avec la JEPA (Joint Embedding Predictive Architecture). Le principe tient en une phrase : au lieu de prédire l’image suivante, le modèle prédit sa représentation abstraite. Deux encodeurs transforment l’état présent et l’état futur en vecteurs, et un prédicteur apprend à passer de l’un à l’autre. Aucun décodeur ne reconstruit l’image. Le modèle n’a donc pas besoin de deviner la position de chaque feuille ; il lui suffit de prévoir que l’arbre reste debout et que la balle tombe.
Les trois autres consignes du slide découlent de ce choix. Sans distribution de probabilités sur des pixels, la cohérence entre deux états se mesure par une fonction d’énergie, faible quand ils sont compatibles. L’inférence devient une recherche : le système cherche l’action qui minimise cette énergie au lieu de produire une réponse en une passe. Et pour éviter que le modèle triche en encodant tout dans un vecteur constant, ce qu’on appelle le collapse, on contraint les représentations par régularisation plutôt que par comparaison avec des exemples négatifs.
Dans le débat de mai 2026, Eric Xing défendait une position intermédiaire : prédire dans un espace latent, mais garder une reconstruction générative pour pouvoir vérifier ce que le modèle a simulé. LeCun répondait que l’imprévisible doit être traité comme du bruit et écarté, pas reconstruit.
Ce que gagne l’approche non générative
La démonstration la plus aboutie à ce jour est V-JEPA 2, publiée par Meta le 11 juin 2025 (l’équipe de Mido Assran et Nicolas Ballas, alors que LeCun dirigeait encore la recherche du groupe). Le modèle compte 1,2 milliard de paramètres.
Son entraînement se fait en deux temps. D’abord plus d’un million d’heures de vidéo internet, sans aucune annotation. Ensuite moins de 62 heures de vidéos de bras robotisés issues du jeu de données public DROID, sans labels, sans récompense, sans indicateur de réussite. Cette seconde phase suffit à produire un modèle conditionné par l’action, capable de prévoir l’effet d’un mouvement du bras.
Résultat : le modèle pilote des bras Franka dans deux laboratoires où il n’avait jamais été entraîné, sans aucune donnée collectée sur place. Meta annonce 65 % à 80 % de réussite en pick-and-place sur des objets nouveaux dans des environnements inconnus.
L’autre gain est la vitesse. Selon les chiffres repris par The Decoder, V-JEPA 2 planifie une action en 16 secondes, contre 4 minutes pour une planification fondée sur la génération vidéo de Cosmos. Meta communique de son côté sur un facteur 30, quand le rapport entre ces deux durées donne 15. L’ordre de grandeur reste celui que prédisait LeCun : un modèle qui ne dessine pas chaque pixel calcule beaucoup moins.
Ce qu’elle perd
L’approche non générative a trois faiblesses, et ses défenseurs le reconnaissent.
Elle est opaque. Un modèle génératif montre ce qu’il imagine : si Genie 3 fait marcher un passant à reculons, l’erreur se voit. Une JEPA ne produit que des vecteurs. Pour savoir si sa simulation est juste, il faut juger ses actions, après coup. C’est précisément l’argument d’Eric Xing, et il pèse lourd pour un ingénieur qui débugge un robot ou pour un organisme de certification médicale, le terrain qu’AMI a choisi avec Nabla.
Elle ne produit rien. Une JEPA n’est pas un outil de génération. Elle ne peut pas fabriquer de données d’entraînement synthétiques ni d’environnements virtuels, l’usage commercial le plus immédiat de Cosmos, ou le rôle que DeepMind donne à Genie 3 comme terrain d’entraînement pour son agent SIMA.
Ses résultats restent modestes. Le pick-and-place est une tâche simple, et un taux d’échec de 20 % à 35 % reste élevé. Sur les tests de raisonnement physique que Meta a publiés avec V-JEPA 2 (IntPhys 2, MVPBench, CausalVQA), les humains atteignent 85 % à 95 % de réussite, et Meta reconnaît un écart net avec tous les modèles, le sien compris. Sur IntPhys 2, qui demande de distinguer une scène physiquement plausible d’une scène impossible, les modèles vidéo actuels sont proches du hasard.
Les modèles génératifs ont leurs propres limites, que DeepMind expose sans détour. Genie 3 ne reste cohérent que quelques minutes, avec une mémoire visuelle d’environ une minute, gère mal les interactions entre plusieurs agents et commet des erreurs physiques. Le chercheur Ben Dickson y voit un défaut de fond : dans un modèle génératif, le monde simulé et sa perception ne font qu’un, sans réalité extérieure contre laquelle se corriger.
Pourquoi ça compte, et à quoi on verra qui avait raison
Les world models visent la robotique, la santé et l’industrie.
Les assistants que vos clients utilisent pour chercher, de ChatGPT à AI Mode, reposent sur des LLM et continueront d’y reposer : LeCun lui-même ne conteste pas leur efficacité sur le texte.
L’enjeu est ailleurs. Une large part de la valorisation du secteur repose sur une hypothèse : créer des LLM de plus en plus massifs finira par produire une intelligence générale. LeCun a mis un milliard de dollars sur la thèse inverse, et l’essentiel du secteur lui donne désormais raison sur un point : il faut un modèle du monde, un « world model » pour y parvenir.
Reste à savoir lequel, et la réponse n’est pas encore à portée de la main.
Trois indicateurs permettront de trancher dans les douze à dix-huit mois si cette approche en JEPA a un avenir :
- les publications d’AMI Labs, qui s’est engagée à publier ses travaux et son code : un successeur de V-JEPA 2 capable de tâches longues, pas seulement de pick-and-place ;
- l’écart sur IntPhys 2 et CausalVQA : le premier modèle qui s’approche des 85 % humains indiquera quelle école apprend réellement la physique ;
- la durée de cohérence des modèles génératifs : si Genie ou Cosmos passent de quelques minutes à plusieurs heures de simulation stable, l’argument de LeCun sur le coût du pixel perdra beaucoup de sa force.
Il est aussi possible que la question soit tout bonnement mal posée.
Plusieurs chercheurs, à commencer par Eric Xing, voient les deux approches comme complémentaires : une représentation abstraite pour planifier, une couche générative pour vérifier et pour entraîner. Si cette synthèse l’emporte, LeCun aura eu raison sur les LLM et tort sur l’interdit de générer selon un modèle probabiliste…
Sources
- Yann LeCun, A Path Towards Autonomous Machine Intelligence, juin 2022
- Assran et al., V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning, arXiv, juin 2025
- Meta AI, Introducing the V-JEPA 2 world model and new benchmarks for physical reasoning
- Google DeepMind, Genie 3: A new frontier for world models
- ECCV 2026, keynote de Yann LeCun
- MIT Technology Review, Yann LeCun’s new venture is a contrarian bet against large language models
- VKTR, Yann LeCun’s AMI Labs Raises $1.03 Billion
- TechCrunch, Nvidia releases its own brand of world models
- The Decoder, Meta’s latest model highlights the challenge AI faces in long-term planning
- TechTalks, Why generative world models aren’t ready for real-world applications
- Podwise, Yann LeCun & Eric Xing on JEPA and GLP, mai 2026
Ce contenu vous a plu ?
Inscrivez-vous gratuitement à notre newsletter et recevez chaque semaine l’actualité du SEO directement dans votre boîte email. Vous pouvez vous désabonner à tout moment !